बहुत से दस्तावेज़ असल में केवल टेक्स्ट की तस्वीर होते हैं: ऑफ़िस स्कैनर से निकला अनुबंध, किसी प्रमाणपत्र की कॉपी, फ़ोन से खींची गई यूज़र मैनुअल की फ़ोटो, या PDF में सेव किया गया फ़ैक्स। सामान्य अनुवाद टूल ऐसी फ़ाइल खोलता है और उसे कुछ नहीं मिलता — अनुवाद करने के लिए कोई टेक्स्ट नहीं, केवल पिक्सेल।
Linigu Translator अब ऐसी फ़ाइलों को OCR (ऑप्टिकल कैरेक्टर रिकग्निशन) से पढ़ता है। यह हर स्कैन किए गए पेज का टेक्स्ट पहचानता है, AI से उसका अनुवाद करता है और अनुवाद को पेज पर उसी जगह वापस रखता है, ताकि परिणाम आपके मूल दस्तावेज़ जैसा ही दिखे। कोई भी शुल्क लगने से पहले आप कीमत और प्रीव्यू देख लेते हैं।
कौन-सी फ़ाइलें OCR से पढ़ी जाती हैं?
जिस पेज में टेक्स्ट लेयर नहीं होती, वहाँ टेक्स्ट पहचान अपने-आप शुरू हो जाती है। आपको कुछ भी चालू नहीं करना पड़ता।
| फ़ाइल | सामान्य उदाहरण | क्या होता है |
|---|---|---|
| स्कैन की गई PDF | ऑफ़िस स्कैनर, फ़ैक्स, आर्काइव कॉपी | हर पेज पहचाना जाता है, अनुवादित होता है और PDF के रूप में फिर से बनता है |
| मिश्रित PDF | स्कैन किए गए परिशिष्ट वाली डिजिटल रिपोर्ट | टेक्स्ट वाले पेज सीधे अनुवादित होते हैं, केवल स्कैन पेज OCR से गुज़रते हैं |
| JPG, PNG, WebP, BMP | मोबाइल फ़ोटो, स्क्रीनशॉट | इमेज एक PDF पेज बनती है, फिर पहचानी और अनुवादित की जाती है |
| TIFF (बहु-पृष्ठ भी) | दस्तावेज़ आर्काइव के स्कैन | हर फ़्रेम अनुवादित PDF का एक पेज बनता है |
टेक्स्ट लेयर वाली डिजिटल PDF का अनुवाद बिना OCR के होता है — देखें Word, Excel, PowerPoint और PDF अनुवाद गाइड।
चरण-दर-चरण: स्कैन से अनुवाद तक
1. स्कैन या फ़ोटो अपलोड करें
ट्रांसलेटर खोलें और फ़ाइल को अपलोड बॉक्स में डालें। Word, Excel, PowerPoint और PDF के साथ-साथ अब यह JPG और PNG इमेज तथा TIFF, WebP और BMP फ़ाइलें भी स्वीकार करता है।
2. पहले कीमत जानें
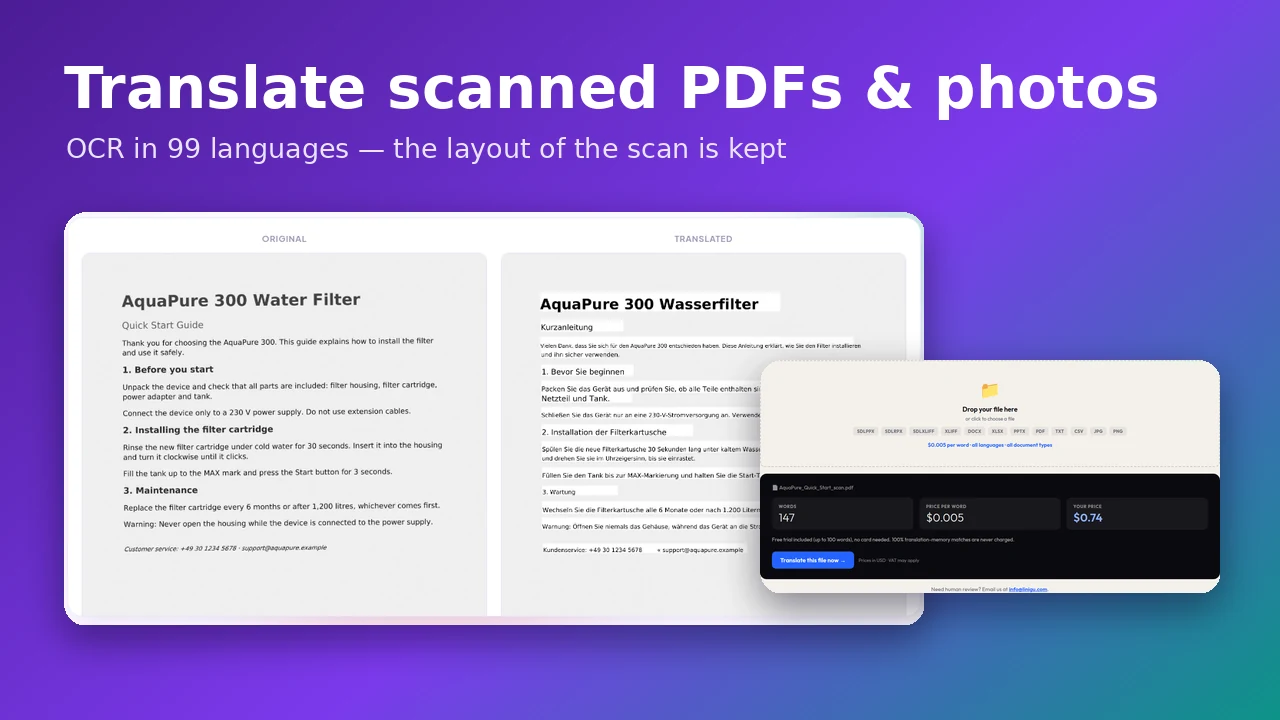
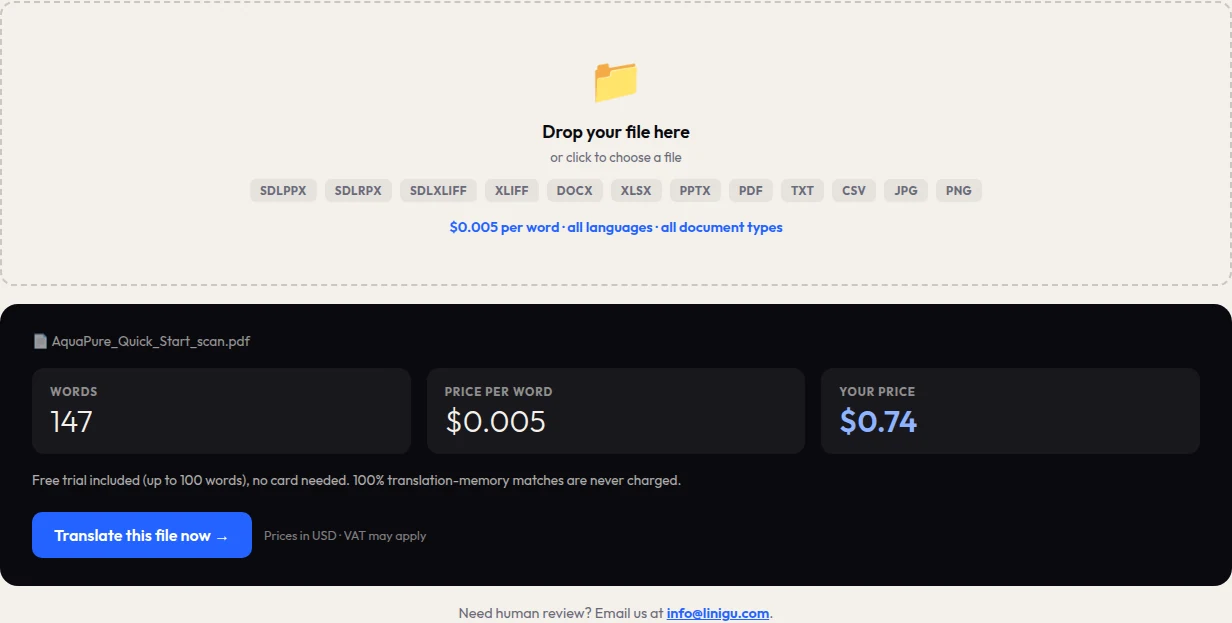
linigu.com होमपेज का कोटेशन बॉक्स स्कैन भी पढ़ता है। हमारी एक पेज की क्विक स्टार्ट गाइड में 147 शब्द पहचाने गए, यानी अनुवाद की कीमत 147 × $0.005 = $0.74 है। कोटेशन के लिए साइन-अप की ज़रूरत नहीं है।
3. OCR प्रीव्यू देखें
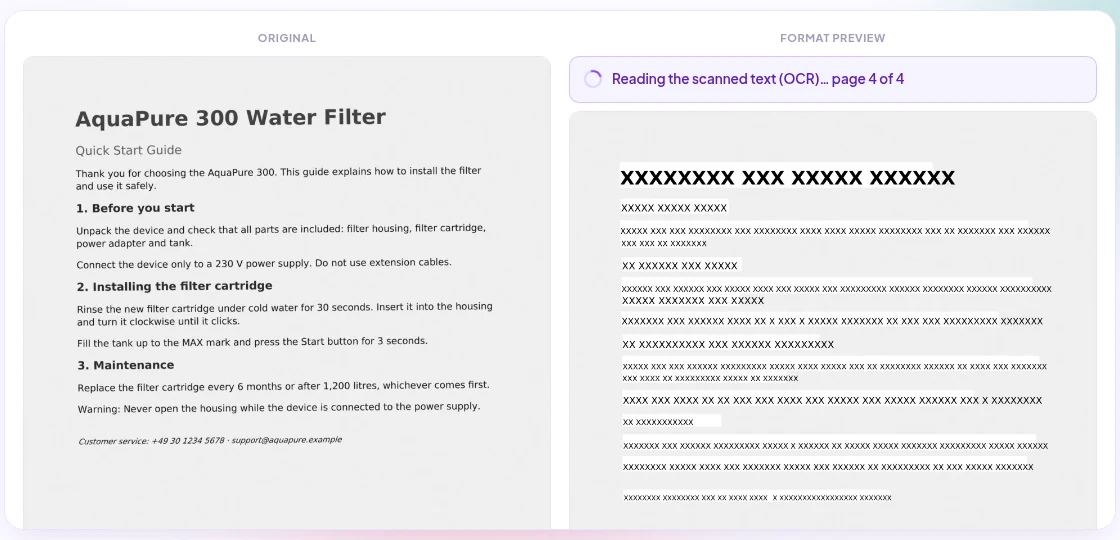
अपलोड के बाद बाईं ओर मूल पेज दिखाई देते हैं। दाईं ओर स्कैन किए गए पेज एक-एक करके पहचाने जाते हैं और प्रोग्रेस बार बताता है कि अभी कौन-सा पेज पढ़ा जा रहा है। बड़े स्कैन में हर पेज पर कुछ सेकंड लगते हैं, और आप पूरे समय प्रगति देख सकते हैं।
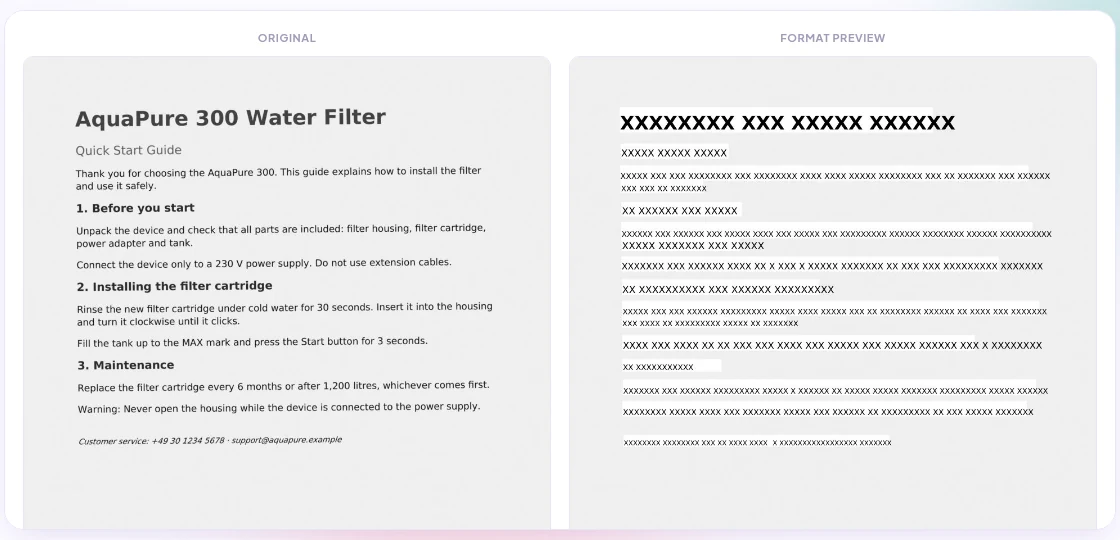
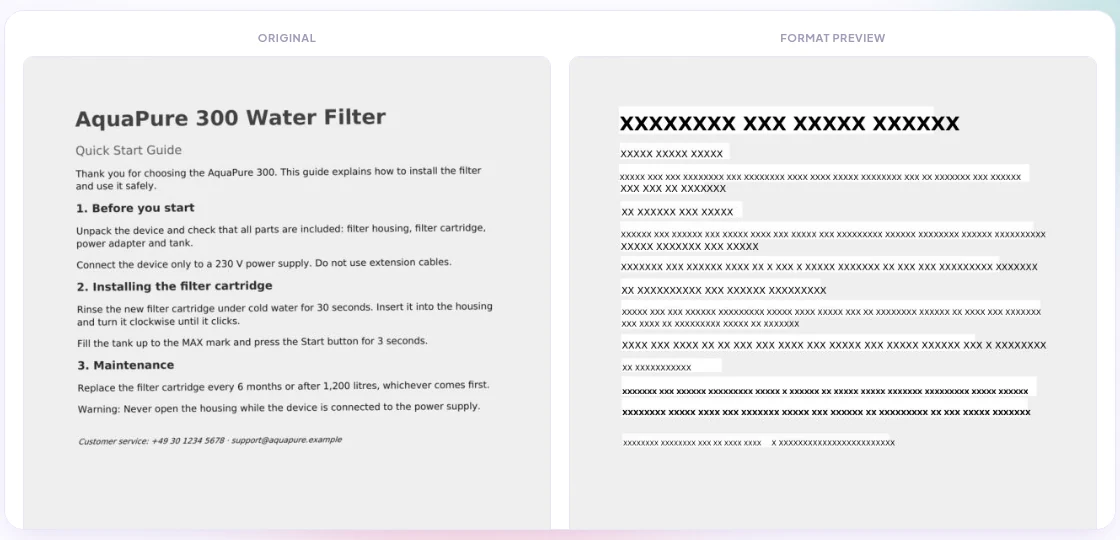
तैयार फ़ॉर्मेट प्रीव्यू हर पहचाने गए शब्द को XXXXX से ढक देता है। इससे ठीक-ठीक दिखता है कि अनुवाद कहाँ लिखा जाएगा — भाषा चुनने और कोई शुल्क लगने से पहले ही। अगर यहाँ कोई टेक्स्ट ब्लॉक नहीं दिखता, तो OCR ने उसे नहीं पढ़ा, और यह आपको भुगतान से पहले पता चल जाता है।
4. भाषाएँ चुनें
118 भाषाओं और वेरिएंट में से लक्ष्य भाषा चुनें। OCR के लिए स्रोत भाषा मायने रखती है: इसे चुनने पर स्कैन उसी भाषा के अपने मॉडल से पढ़ा जाता है, जिससे मात्राएँ, संयुक्ताक्षर, जर्मन उमलाउट या फ़्रेंच एक्सेंट सही आते हैं। "Detect automatically" (अपने-आप पहचानें) पश्चिमी यूरोपीय भाषाओं के लिए अच्छा काम करता है; हिंदी, रूसी, अरबी, चीनी और अन्य लिपियों के लिए भाषा स्वयं चुनें।
5. अनुवाद करें और डाउनलोड करें
Translate document पर क्लिक करें। पहचाना गया टेक्स्ट अनुवादित होता है, मूल शब्द ढक दिए जाते हैं और अनुवाद उन्हीं जगहों पर उपयुक्त आकार में लिखा जाता है। आपको ऐसी PDF मिलती है जिसमें स्कैन का पेज, इमेज और लेआउट बना रहता है।
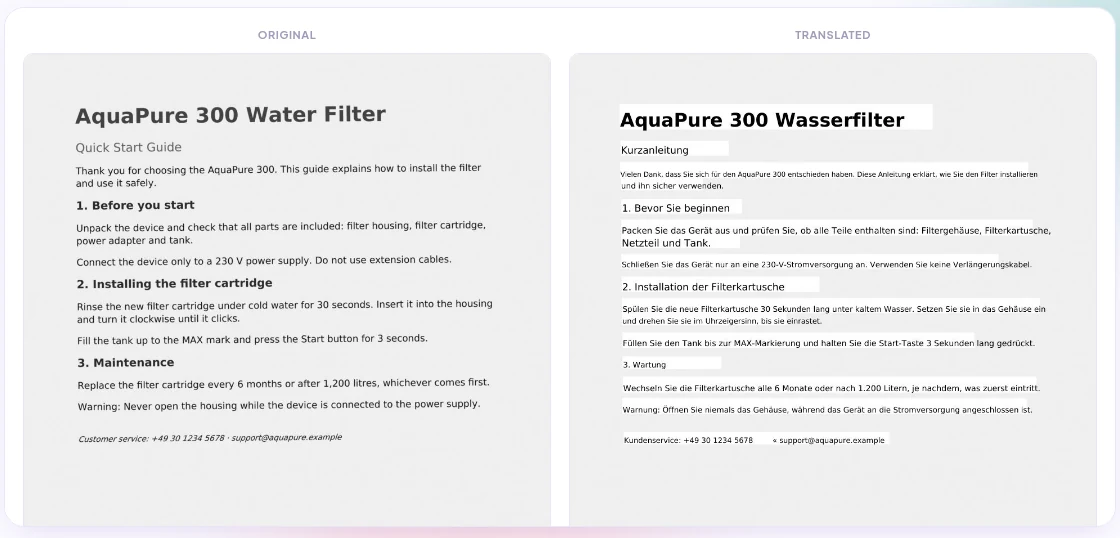
मोबाइल फ़ोन की फ़ोटो भी चलती है
पास में स्कैनर नहीं है? पेज की फ़ोटो लें और JPG अपलोड करें। Linigu फ़ोटो को सामान्य पेज आकार में बदल देता है, इसलिए कैमरे की बड़ी इमेज भी जल्दी प्रोसेस होती है। नीचे का प्रीव्यू वही क्विक स्टार्ट गाइड दिखाता है — स्कैन के बजाय फ़ोटो के रूप में।
सबसे अच्छे OCR परिणाम के लिए सुझाव
- रिज़ॉल्यूशन: 300 dpi पर स्कैन करें। कम रिज़ॉल्यूशन पर छोटे अक्षर पढ़ना मुश्किल होता है।
- सीधा और समतल: पेज की फ़ोटो ठीक ऊपर से, अच्छी रोशनी में, बिना छाया और बिना मुड़े पेज के लें।
- स्रोत भाषा चुनें: हर गैर-पश्चिमी यूरोपीय भाषा के लिए, और देवनागरी जैसी गैर-लैटिन लिपियों के लिए हमेशा।
- संख्याएँ और नाम जाँचें: OCR मिलते-जुलते अक्षरों (0/O, 1/l) में गड़बड़ कर सकता है, और अनुबंध में एक गलत अंक भारी पड़ सकता है।
- केवल छपा हुआ टेक्स्ट: हाथ की लिखावट भरोसेमंद ढंग से नहीं पहचानी जाती।
ध्यान रखने योग्य बातें
- हर फ़ाइल में अधिकतम 50 स्कैन पेज पहचाने जाते हैं। उसी PDF के डिजिटल पेज इस सीमा में नहीं गिने जाते।
- होमपेज कोटेशन अधिकतम 20 स्कैन पेज पढ़ता है, जो अधिकांश दस्तावेज़ों का अनुमान लगाने के लिए काफ़ी है।
- अनुवाद पहचाने गए टेक्स्ट क्षेत्रों में रखा जाता है। बहुत जटिल टेबल, मुहरें और हाथ से लिखे नोट्स जैसे हैं वैसे ही रहते हैं, उनका अनुवाद नहीं होता।
- फ़ाइलें केवल आपके सेशन के लिए प्रोसेस होती हैं और 48 घंटे बाद अपने-आप हटा दी जाती हैं। स्कैन स्वयं कभी AI मॉडल को नहीं भेजा जाता — केवल पहचाना गया टेक्स्ट अनुवादित होता है।
इसकी कीमत क्या है?
स्कैन की कीमत किसी भी अन्य दस्तावेज़ जैसी ही है: हर भाषा में $0.005 प्रति शब्द, OCR के लिए कोई अतिरिक्त शुल्क नहीं। पहले 100 शब्द मुफ़्त हैं, टॉप-अप $10 से शुरू होते हैं और बैलेंस कभी समाप्त नहीं होता।
अक्सर पूछे जाने वाले प्रश्न
क्या मैं स्कैन की गई PDF का मुफ़्त अनुवाद कर सकता हूँ?
हाँ, मुफ़्त ट्रायल में पहले 100 शब्द शामिल हैं — एक छोटे पत्र या प्रमाणपत्र के लिए काफ़ी। कोटेशन और फ़ॉर्मेट प्रीव्यू हमेशा मुफ़्त हैं।
OCR कौन-सी भाषाएँ पढ़ सकता है?
टेक्स्ट पहचान (Tesseract) 99 भाषाएँ जानता है, जिनमें लैटिन, सिरिलिक, ग्रीक, अरबी और हिब्रू लिपियाँ, चीनी, जापानी, कोरियाई, हिंदी और अन्य भारतीय लिपियाँ शामिल हैं। अनुवाद 118 भाषाओं और वेरिएंट में किया जा सकता है।
क्या स्कैन दस्तावेज़ का प्रमाणित अनुवाद मिल सकता है?
ऑनलाइन ट्रांसलेटर AI अनुवाद देता है। प्रमाणपत्र या आधिकारिक रिकॉर्ड जैसे स्कैन दस्तावेज़ों के नोटरीकृत या प्रमाणित अनुवाद के लिए हमें info@linigu.com पर लिखें, हम आपको व्यक्तिगत कोटेशन भेजेंगे।
जो अनुवाद मेरे पास केवल स्कैन के रूप में है, उसे कैसे जाँचूँ?
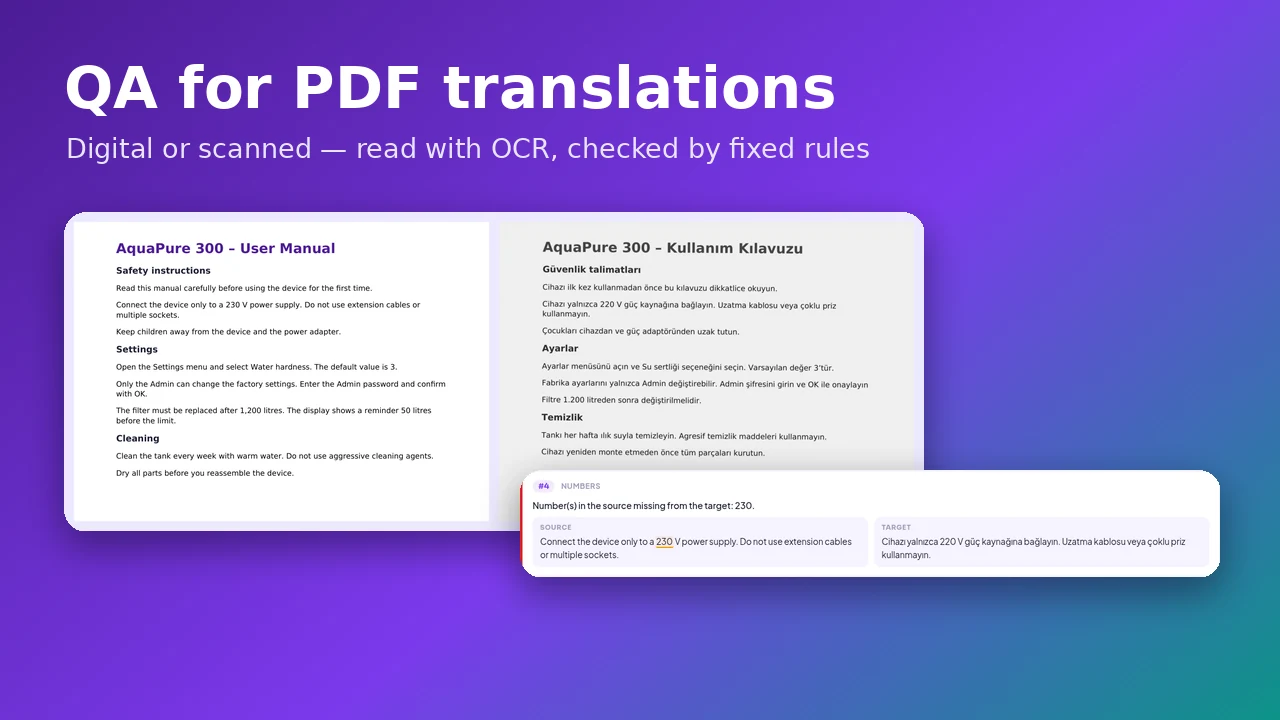
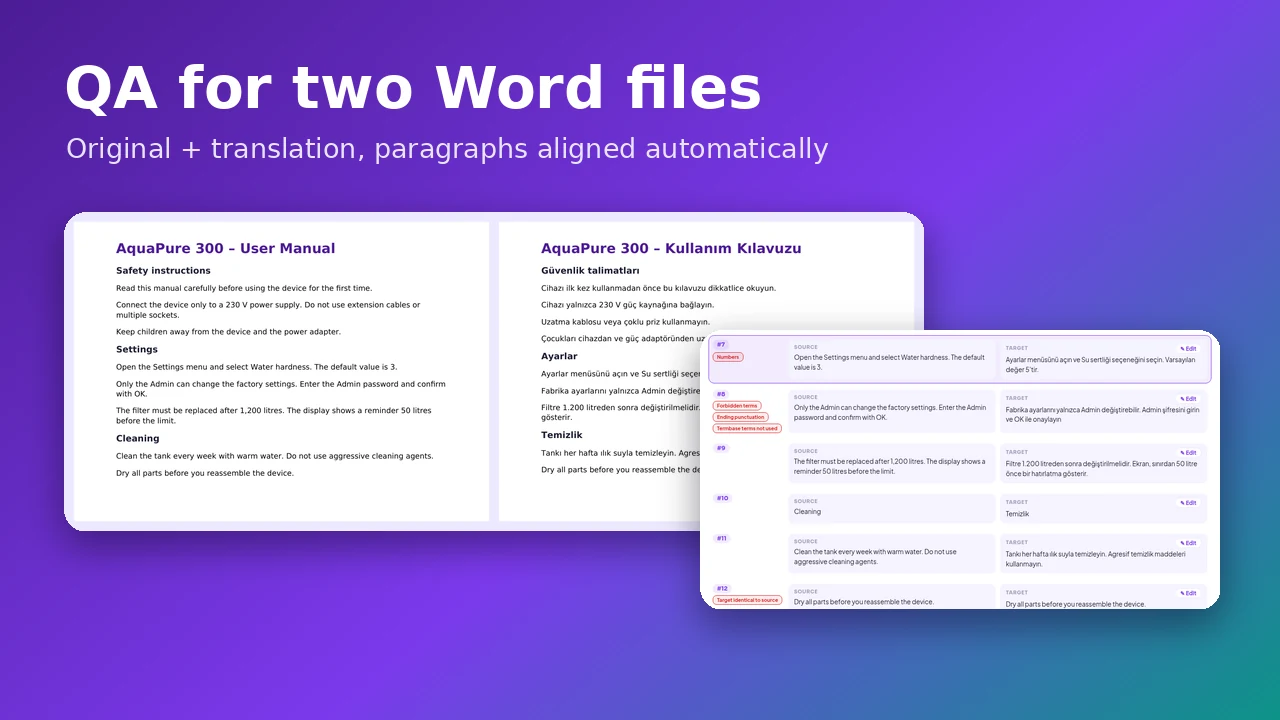
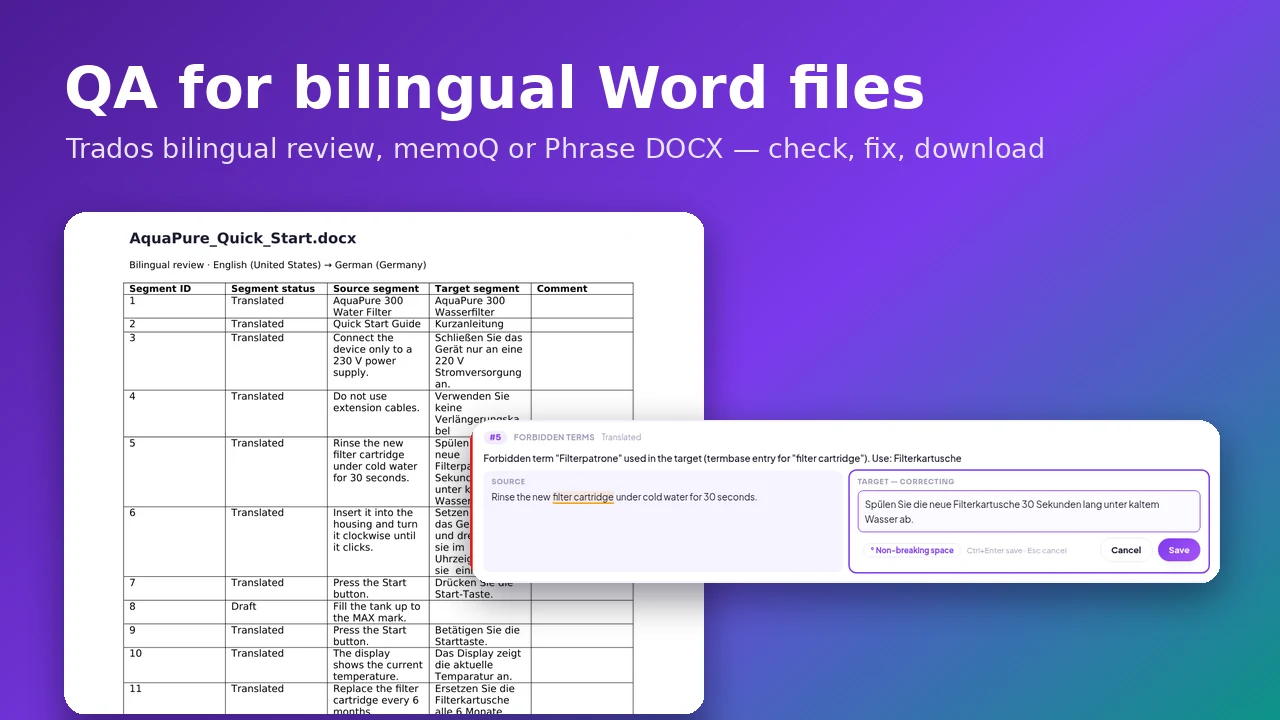
QA Checker से: यह स्कैन या डिजिटल PDF अनुवाद की तुलना मूल दस्तावेज़ से करता है। पढ़ें PDF अनुवाद की जाँच कैसे करें, स्कैन वाले भी।
आज़माना चाहते हैं? Linigu Translator पर कोई स्कैन या फ़ोटो अपलोड करें और कुछ ही सेकंड में फ़ॉर्मेट प्रीव्यू देखें। बाकी सभी फ़ॉर्मेट के लिए पढ़ें हर फ़ाइल फ़ॉर्मेट का ऑनलाइन अनुवाद कैसे करें।